一言まとめ
WeMM-Embeddingは、微信(WeChat)ビジョンチームがオープンソース化した汎用マルチモーダルベクトルモデルファミリーであり、テキスト・画像・動画・ビジュアルドキュメントを統一して同一のベクトル空間にエンコードする。2B/4B/9Bの3サイズを展開し、そのうち9Bは80.6点でMMEB-v2の首位、59.5点でMMEB-v3の首位を獲得。さらに、視頻号(WeChat Channels)・公衆号(WeChat公式アカウント)・朋友圈(モーメンツ)など微信のコア業務にすでに実装済みである——実験室のデモではなく、「本番投入を恐れない」プロダクションモデルである。
背景:なぜマルチモーダルEmbeddingが必要なのか
まず基礎概念を2つ説明する。Embedding(埋め込み/ベクトル)とは、テキストや画像などのコンテンツを一連の数値ベクトルに変換し、コンピュータが「2つのコンテンツがどれだけ似ているか」を計算できるようにするものである。ベクトルが近いほど、コンテンツは類似している。検索エンジンのリコール、レコメンドシステムのマッチング、ナレッジベースの検索は、いずれも根本的にはEmbeddingに依存している。
従来の検索は「テキストでテキストを検索、画像で画像を検索」するもので、モダリティをまたぐ場合は変換システムを別途構築する必要があった。マルチモーダルEmbeddingの目標は、テキスト・画像・動画・ドキュメントをすべて同一のベクトル空間にエンコードし、「一言で動画を探す」「画像でドキュメントを探す」「テキスト記述で類似商品を探す」といった能力に統一的な基盤を提供することである。
マルチモーダルEmbeddingの実現には2つの主流ルートがあり、それぞれ課題がある。
- 双塔CLIP系アーキテクチャ:画像・テキストをそれぞれエンコードしてからアラインメントするため、モダリティ経路が分断されており、「画像とテキストの混合」入力や複雑な推論を直接モデル化しにくい。
- マルチモーダル大規模モデル(MLLM)をそのままエンコーダとして使う方法:細粒度のランキング能力が不十分で、負例を誤って傷つけやすく、計算コストも大きい。
WeMM-Embeddingは、まさにこれらの課題に対して打ち出された新たなソリューションである。
モデル概要:1つのファミリー、3つのサイズ
WeMM-Embeddingの正式名称は WeChat Multi-Modal Embedding で、テンセント微信ビジョンチーム(WeChat Vision)が研究開発し、2026年8月下旬に正式にオープンソース化された。コードとモデル重みが一括公開され、Apache 2.0ライセンスを採用している。
| モデル | パラメータ数 | Matryoshka選択可能次元 | 最大出力次元 | Hugging Face |
|---|---|---|---|---|
| WeMM-Embedding-2B | 20億 | 64 / 128 / 256 / 512 / 1024 / 2048 | 2048 | 🤗 モデルページ |
| WeMM-Embedding-4B | 40億 | 64 / 128 / 256 / 512 / 1024 / 2560 | 2560 | 🤗 モデルページ |
| WeMM-Embedding-9B | 90億 | 64 / 128 / 256 / 512 / 1024 / 2048 / 4096 | 4096 | 🤗 モデルページ |
3バージョンすべてが対応しているのは、テキスト・画像・動画・ビジュアルドキュメント(スクリーンショット、PDFレイアウトページ、レシートなど)、および任意に交錯したマルチモーダル入力(1つのテキストに複数の画像や複数の動画が混在する場合も可)である。現行バージョンは音声入力に非対応である。
ベクトルはどう算出されるのか
WeMM-Embeddingのベクトル抽出手法は非常に簡潔である。入力をまず「タスク指示+順序付きマルチモーダルセグメント」として構成し、シーケンス末尾に専用の <embedding> トークンを付加し、そのトークン位置の最終層の隠れ状態を取り出し、L2正規化を施したものが出力ベクトルとなる。
この <embedding> トークンは複数配置できる。例えば「動画+字幕テキスト」を処理する場合、動画トークンの後に1つ、シーケンス末尾にもう1つ配置すれば、1回の前方推論で「純粋な動画表現」と「動画とテキストの融合表現」を同時に得ることができ、非常に柔軟である。
Matryoshka:出力次元の切り詰めが可能
WeMM-Embeddingは Matryoshka Representation Learning(MRL、入れ子表現学習) に対応している。すなわち、まず高次元ベクトル(2048/4096次元など)を学習し、デプロイ時に必要に応じて先頭の数次元を切り出して再正規化することで、より短く、保存・計算コストの低い低次元ベクトルを得られる。
公式技術レポートが示すデータによると、MMEB-v2において、2Bモデルを256次元に圧縮した場合でも、全次元での画像・動画検索性能の98.7%を維持している。これにより開発者は、効果・速度・コストの間で必要に応じてトレードオフを取れる。検索量が極めて大きくレイテンシに敏感なシーンでは、低次元ベクトルを使えばストレージと計算リソースを大幅に節約できる。
技術的要点:ネイティブマルチモーダル基盤+2段階学習
Qwen3.5ネイティブマルチモーダルアーキテクチャを基盤に採用
Hugging Faceのモデルカードおよび複数メディアの報道によると、WeMM-EmbeddingはネイティブマルチモーダルアーキテクチャQwen3.5を基盤として構築されている(Qwen3.5は通義(Tongyi)チームが発表したネイティブ視覚言語モデルで、テキストと視覚を早期融合し、多言語に対応する)。ネイティブマルチモーダル基盤の採用は、モデルが事前学習段階ですでに「画像とテキストの混合理解」能力を備えていることを意味し、「後から2つの単一モーダルモデルを組み合わせる」よりも統一表現の目標に適合している。
統一されたPairデータプロトコル
分類、画像テキスト検索、動画位置特定、質問応答推論など多種多様なタスクを統一的に処理するため、研究チームはすべてのタスクを「ソースインスタンス vs ターゲット候補」間の関連性測定に抽象化し、数億件規模のマルチモーダル学習コーパスを構築した。以下の6大カテゴリのデータをカバーしている。
- 弱教師付き画像テキスト/動画ペア:ネット上の自然なアラインメントを大量に含むデータで、粗粒度のクロスモーダル意味事前知識を提供する。
- 細粒度記述ペア(Caption Pairs):物体属性、空間関係、長距離因果、動的イベントをカバーする高品質で密な記述。
- クロスモーダル検索ペア(Retrieval Pairs):組み合わせ検索、長文脈検索、空間的位置特定、エージェントツール/GUI検索など。
- 分類ペア(Classification Pairs):認識タスクを「ソースインスタンス ↔ カテゴリ記述」のマッチングに変換する。
- マルチモーダル質問応答ペア(QA Pairs):OCR、ドキュメント・図表解析、時空間論理推論など。
- 段階的関連性ペア(Graded Relevance Pairs):複数段階の関連度アノテーションで、検索・レコメンドの細かいランキングニーズに対応する。
2段階学習とクロススケール知識蒸留
学習は2段階に分かれる。
- 大規模マルチモーダルアラインメント:数億件規模のペアデータで学習する。標準的なペアデータには対照学習目的を、段階的関連性アノテーション付きデータにはランキング目的を用い、ほぼ重複するサンプルにはマスキングを施す。
- 精選データによる精錬:第1段階の約10分の1の規模の精選データで精錬する。精選セットは、セマンティックIDによる逆密度リサンプリング(ロングテールデータ向け)、マルチモーダル大規模モデルによるクリーニング・書き換え、モダリティ適応型ハード負例マイニングの3つの手段で構築され、再ランキングモデルの教師信号と「同ファミリーのより大きなモデル」の埋め込み蒸留を導入している。
技術レポートおよびメディア報道によると、2Bと4Bは凍結した9Bバージョンを教師として蒸留を完了し、9Bは複数の補完的バリアントを統合して得られ、より高解像度の入力とより密な動画フレームサンプリングによって視覚入力バジェットを拡張している。これが「小モデルが大モデルを越える」鍵である。
評価比較:MMEB-v2とMMEB-v3
以下の成績はすべてテンセント技術レポート(arXiv:2608.24053)からの出典で、スコアは高いほど良い。注意:これはモデル公式の自己報告データであり、一部の比較ベースラインはクローズドなベンチマーク提出であるため、解釈には文脈を踏まえる必要がある。
MMEB-v2(78データセット)
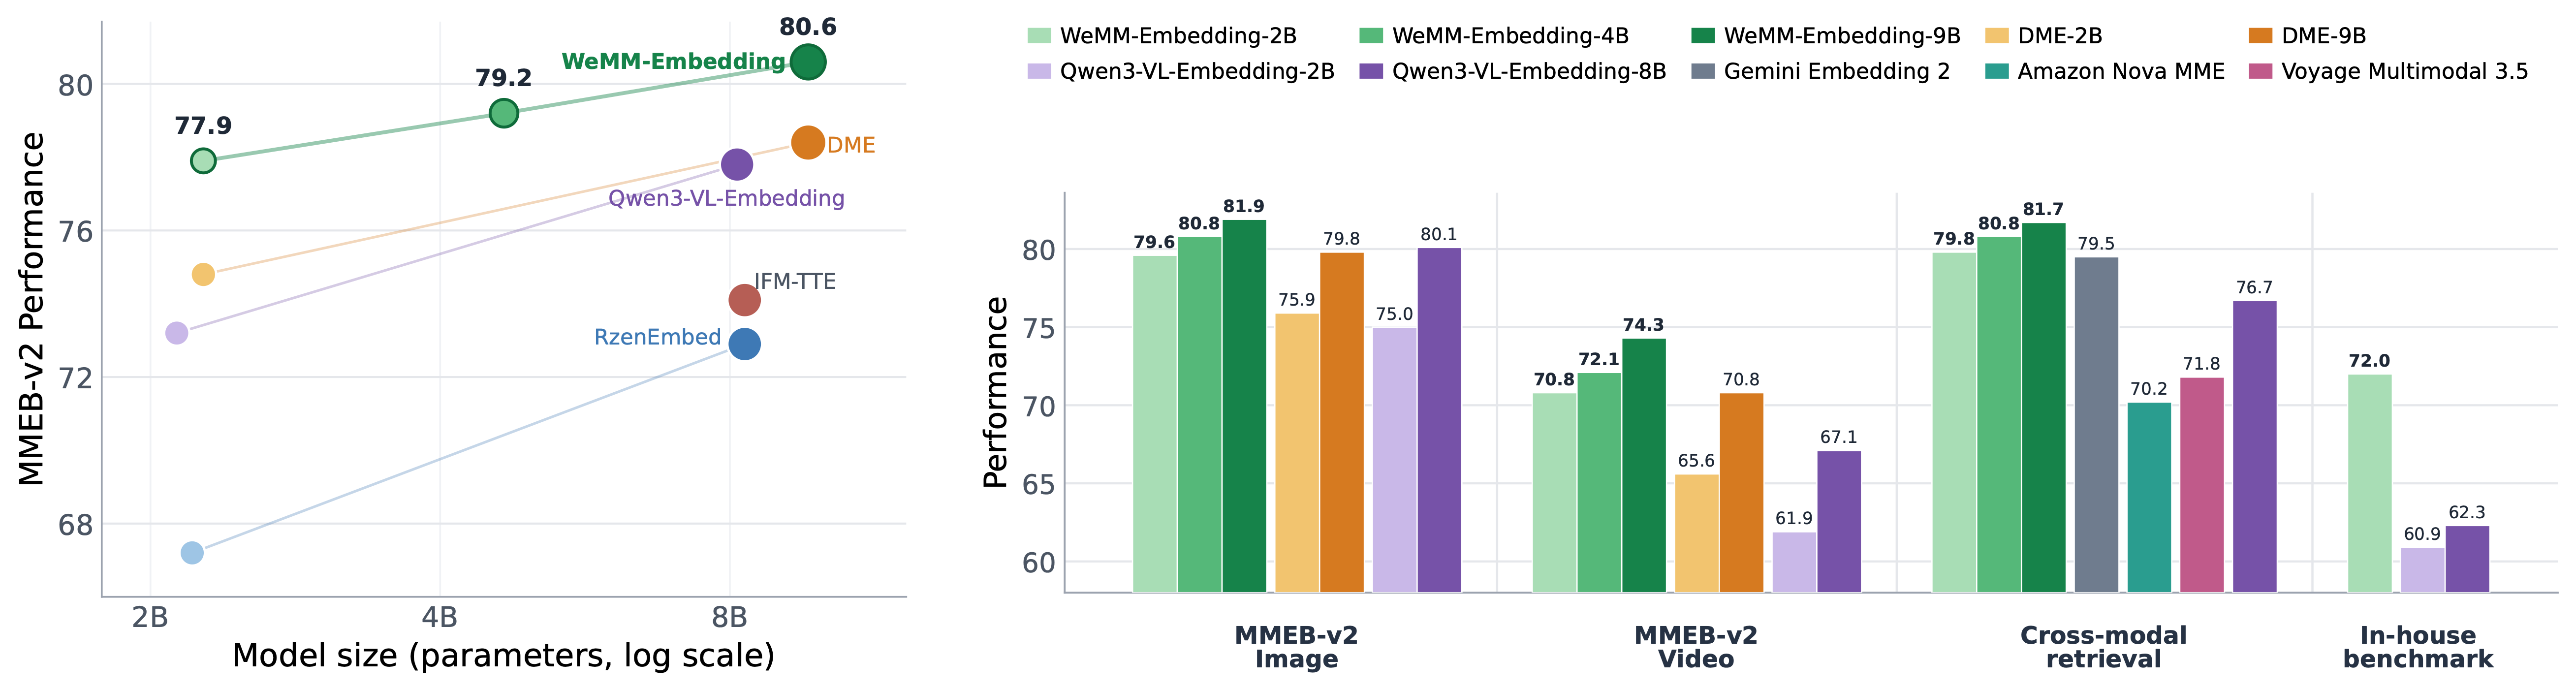
画像・動画タスクはHit@1、ビジュアルドキュメントタスクはNDCG@5を使用:
| モデル | パラメータ数 | AVG | Image | Video | VisDoc |
|---|---|---|---|---|---|
| VLM2Vec | 2B | 47.8 | 59.7 | 29.0 | 44.0 |
| GME | 2B | 55.4 | 51.9 | 33.9 | 76.8 |
| VLM2Vec-V2 | 2B | 59.3 | 64.9 | 34.9 | 69.2 |
| Qwen3-VL-Embedding | 2B | 73.2 | 75.0 | 61.9 | 79.2 |
| DME-Small† | 2B | 74.8 | 75.9 | 65.6 | 79.9 |
| WeMM-Embedding | 2B | 77.9 | 79.6 | 70.8 | 80.7 |
| WeMM-Embedding | 4B | 79.2 | 80.8 | 72.1 | 82.0 |
| VLM2Vec | 8B | 53.2 | 65.5 | 34.0 | 49.1 |
| GME | 8B | 59.2 | 56.0 | 38.6 | 79.3 |
| Qwen3-VL-Embedding | 8B | 77.8 | 80.1 | 67.1 | 82.4 |
| DME-Medium† | 9B | 78.4 | 79.8 | 70.8 | 82.0 |
| WeMM-Embedding | 9B | 80.6 | 81.9 | 74.3 | 83.3 |
† クローズドなベンチマーク提出で、モデル重み未公開または公開推論インターフェースなし。
注目すべき点は2つある。
- 2Bが8Bを越える:WeMM-Embedding-2B(77.9)は、それまで先行していたオープンソース8BベースラインQwen3-VL-Embedding-8B(77.8)を上回った。なおQwen3-VL-EmbeddingもQwen3-VLを基盤とするマルチモーダルEmbeddingモデルで、2026年1月に発表され、それ以前はMMEB-v2のオープンソース最良モデルだった。
- 9Bが首位:総合平均80.6点で、公開・商用クローズドモデルすべてを上回った(DME-Mediumの78.4を含む)。
MMEB-v3(190タスク)
V3-Allは、78個のMMEB-v2タスク、53個のテキストタスク、47個のエージェントタスク、11個の音声タスク、およびMCMR(マルチモーダル組み合わせ検索)を含む。テキストタスクはNDCG@5、エージェント/MCMR/音声はHit@1を使用し、非対応タスクは0点として計算される:
| モデル | パラメータ数 | V3-All | Text | Agent | MCMR | Audio |
|---|---|---|---|---|---|---|
| VLM2Vec-V2 | 2B | 38.3 | 24.5 | 28.7 | 4.1 | 0.0 |
| Omni-Embed-Nemotron | 3B | 43.5 | 39.2 | 36.5 | 26.1 | 36.5 |
| E5-Omni | 3B | 44.6 | 26.7 | 36.9 | 31.9 | 30.8 |
| Qwen3-VL-Embedding | 2B | 50.9 | 39.2 | 39.3 | 42.0 | 0.0 |
| WeMM-Embedding | 2B | 56.0 | 45.3 | 45.1 | 42.5 | 0.0 |
| WeMM-Embedding | 4B | 58.2 | 47.9 | 49.0 | 41.9 | 0.0 |
| WAVE | 7B | 26.3 | 13.7 | 11.3 | 8.9 | 31.8 |
| VLM2Vec | 8B | 32.9 | 22.2 | 19.7 | 0.9 | 0.0 |
| LCO-Embedding-Omni | 7B | 40.6 | 32.4 | 27.8 | 20.0 | 43.2 |
| GME | 8B | 43.6 | 37.1 | 35.6 | 27.3 | 0.0 |
| E5-Omni | 7B | 47.1 | 26.9 | 36.7 | 41.1 | 43.0 |
| Tianmu-Emb-Uni | 8B | 53.3 | 43.6 | 39.4 | 38.8 | 38.9 |
| Qwen3-VL-Embedding | 8B | 53.5 | 42.5 | 38.4 | 38.0 | 0.0 |
| WeMM-Embedding | 9B | 59.5 | 48.8 | 51.0 | 49.3 | 0.0 |
MMEB-v3の結論はより慎重に解釈する必要がある。WeMM-Embeddingは音声非対応で、音声タスクは0点となるため、その総合点は「音声トラックを放棄した」前提で得られたものである。逆に、音声対応のE5-Omni、LCO-Embedding-OmniなどはV3-Allで音声タスクに足を引っ張られている。Text/Agent/MCMRの3項目だけを見れば、WeMM-Embedding-9Bはすべて1位である。
評価の再現性
コミュニティによる再現を容易にするため、微信チームはMMEB-v3の完全な評価コードを公開している(リポジトリ mmeb_v3_eval/ ディレクトリ)。これは公式VLM2Vec評価パイプラインに最小限の変更を加えたもので、マルチノード・マルチGPU推論対応、WeMM-Embeddingの前処理とバッチ推論に適合したバックボーン、データ指示のアラインメント、64フレーム動画サンプリングが含まれる。この点は信頼性にとって極めて重要である。評価プロセスが既存の権威あるベースラインと一貫しており、独自に作り直したものではないからだ。
実装:デモではなく、すでに微信業務で稼働中
WeMM-Embeddingの最大のハイライトの1つは実際の本番導入である。技術レポートの要約とメディア報道によると、本モデルファミリーは視頻号・公衆号・朋友圈・EC(および搜一搜などの検索シーン)で大規模にデプロイされ、コンテンツリコール・検索・レコメンドに貢献している。
- 26項目の微信内部タスクのベンチマークで顕著な改善を達成。
- 14回のオンラインA/Bテストを完了し、すべてで一貫した改善が確認された。
- つまり、あなたが視頻号をスクロールし、公衆号を検索し、朋友圈のレコメンドを見るとき、その背後ではすでにこのベクトルモデルが動いている可能性がある。
「本番投入できてこそ真に戦える」——これは評価データ以上に、WeMM-Embeddingで最も注目すべき点である。
クイックスタート
環境準備
公式では、前処理動作を学習時と一致させるため transformers==5.2.0 の使用を推奨している(より新しいバージョンでは前処理に差異が生じる可能性がある):
pip install torch transformers==5.2.0 "qwen-vl-utils[decord]==0.0.14" \
  "sentence-transformers>=5.7.0" "accelerate>=1.1.0"
Transformersでの推論
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
--dimension 2048サンプルはテキスト・画像・動画それぞれの独立したEmbeddingを生成する。--dimension を省略するとフル次元を出力する。--model はHugging FaceのモデルID(例:tencent/WeMM-Embedding-2B)にも対応している。
Sentence Transformers
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("tencent/WeMM-Embedding-9B", trust_remote_code=True)
embeddings = model.encode(["今日はいい天気だ。", "It's so sunny outside!"])
テキスト・画像・動画はすべて encode() で統一処理され、MRL次元は --dimension で指定する。
オンラインサービスデプロイ
公式ではvLLM 0.27.0 とSGLang 0.5.9 での動作が確認されている:
# vLLM
MODEL_PATH=/path/to/WeMM-Embedding-2B
vllm serve "$MODEL_PATH" \
  --runner pooling \
--chat-template "$MODEL_PATH/embedding_chat_template.jinja"# SGLang
MODEL_PATH=/path/to/WeMM-Embedding-2B
python scripts/patch_sglang_video.py
python -m sglang.launch_server \
--model-path "$MODEL_PATH" \
--is-embedding \
--enable-precise-embedding-interpolationリポジトリにはワンクリックスクリプト scripts/serve_vllm.sh と scripts/serve_sglang.sh も用意されている。
制限と注意事項
- 音声非対応:現行バージョンは音声入力を受け付けず、MMEB-v3の音声タスクは0点となる。音声と動画を統一的に検索する必要があるシーンには現状適さない。
- 自己報告の評価データ:MMEB-v2/v3の成績はテンセントの技術レポートに基づく公式自己報告であり、第三者による独立した再現が待たれる。
- 比較ベースラインの口径:MMEB-v2の表にはクローズドなベンチマーク提出(DME-Small/Medium、†付き)が含まれており、横断比較の際はこれらが重みを公開していない点に注意が必要である。
- バージョン依存性:公式では
transformers==5.2.0への固定を推奨しており、アップグレード前には回帰検証が必要。コミュニティではすでに新しいtransformersおよびsentence-transformersとの統合に関する問題が議論されている(Hugging Faceモデルページのdiscussions)。 - オープンソースだが商用検証済み:モデル重みとコードはApache 2.0で完全オープンソースであるが、微信内でのデプロイデータ(26タスクの内部ベンチマーク、14回のA/Bなど)は技術レポートにのみ記載され、外部からは再現できない。
データソースと参考情報
本文の事実は公式チャネルを基準とし、複数メディアによるクロスチェックを経ている:
- 公式GitHubリポジトリ(中英README、評価コード含む):github.com/Tencent/WeMM-Embedding
- 技術レポート(arXiv 2608.24053):arxiv.org/abs/2608.24053
- Hugging Faceモデルコレクション:huggingface.co/collections/tencent/wemm-embedding
- Hugging Face論文ページ(要約と学習詳細を含む):huggingface.co/papers/2608.24053
- 智猩猩/テンセントニュース「微信竟把"隐形AI"开源了」:news.qq.com
- 我爱计算机视觉「2B超越8B基线,9B登顶MMEB-v2榜首」:sohu.com
- 動点科技「微信团队开源 WeMM-Embedding」:sohu.com
- 比較ベースライン Qwen3-VL-Embedding 技術レポート:Qwen3-VL-Embedding